
Mein kurzes Fazit vorweg: ML erkennt Schäden meist besser, sobald Fotos unruhig, gemischt oder schwer vergleichbar sind. Regelmodelle sind dagegen oft im Vorteil, wenn Bilder immer gleich aufgenommen werden und die Prüfschritte fest sind.
Wenn ich den Artikel auf das Wesentliche kürze, komme ich auf vier Punkte:
- Regelmodelle brauchen anfangs wenig Bilddaten und sind leichter zu prüfen.
- ML-Modelle sind bei wechselndem Licht, Perspektiven und mehreren Schäden pro Bild meist treffsicherer.
- Regelmodelle stoßen bei Glanz, Schatten, Schmutz und neuen Fahrzeugformen oft an Grenzen.
- Im Gutachtenprozess passt oft die Mischung am besten: Regeln prüfen den Ablauf, ML wertet die Schäden aus, während im Vergleich KI vs. Mensch der Mensch am Ende entscheidet.
Ein paar Zahlen aus dem Text zeigen die Richtung klar:
- Bis zu 96,3 % Erkennungsrate in Studien
- Bis zu 94,3 % Testgenauigkeit
- 85,7 % mAP für DamageNet auf VehiDE
- 94,1 % Validierungsgenauigkeit für ResNet50
- Bei regelbasierten Systemen kann die False-Reject-Rate auf bis zu 12 % steigen, wenn Bildlagen schwieriger werden
Quick Comparison
| Kriterium | Regelmodell | ML-Modell |
|---|---|---|
| Startaufwand bei Daten | Niedrig | Hoch |
| Verhalten bei festen Aufnahmebedingungen | Stark | Stark |
| Verhalten bei wechselnden Bildern | Schwächer | Meist besser |
| Erklärbarkeit | Hoch | Niedriger |
| Pflege | Regeln per Hand nachziehen | Retraining, Audits, Monitoring |
| Gut geeignet für | Feste Prüffälle, standardisierte Fotos | Freie Fotos, gemischte Schäden, mobile Aufnahmen mit KI |
Wenn du nur eine Antwort suchst: Bei Standardbildern reicht ein Regelmodell oft aus. Bei Bildvielfalt und schwereren Fällen liegt ML meist vorn. Am Ende zählt aber nicht nur die Trefferquote, sondern auch, ob sich das Ergebnis im deutschen Gutachten sauber prüfen und belegen lässt.
sbb-itb-d35113a
Regelbasierte Modelle: klare Logik, geringer Datenbedarf, begrenzte Flexibilität
Wie regelbasierte Erkennung sichtbare Schäden identifiziert
Regelbasierte Systeme prüfen fest definierte Bildmerkmale wie Kanten, Helligkeit, Farbe und Konturen. Ein Kratzer gilt zum Beispiel dann als erkannt, wenn eine Linie mit hohem Kontrast eine festgelegte Länge oder Intensität überschreitet oder wenn eine geometrische Abweichung auf einen Schaden hinweist. Der Knackpunkt liegt aber woanders: Wie gut halten diese Regeln stand, wenn sich die Bildsituation ändert?
Bei der Fahrzeugaufnahme hat dieser Ansatz einen klaren Pluspunkt. Jede Entscheidung lässt sich direkt auf eine messbare Regel zurückführen. Das macht das Ergebnis gut nachvollziehbar und leicht zu prüfen. Oft genügen schon wenige Referenzbilder, weil die Regeln von Hand festgelegt werden. Sobald sich jedoch Beleuchtung, Blickwinkel oder Oberflächen ändern, fällt die Trefferquote oft ab.
Wo regelbasierte Systeme gut funktionieren – und wo nicht
Unter kontrollierten Bedingungen arbeiten regelbasierte Modelle bei der Schadenprüfung zuverlässig. Das gilt vor allem bei gleichmäßiger Beleuchtung, festen Kamerawinkeln, ruhigen Oberflächen und klar sichtbaren Schäden wie deutlichen Dellen oder Rissen. In solchen Fällen lassen sich Regeln eng auf einen erwartbaren Bildbereich zuschneiden.
Schwierig wird es, wenn die Bildverhältnisse schwanken. Glanz, Schatten, Schmutz oder wechselnde Aufnahmewinkel können dazu führen, dass Kantenoperatoren Reflexionen als Kratzer deuten oder echte Schäden übersehen. Genau dann zeigt sich die Schwäche fester Regeln.
Besonders heikel sind überlagerte Schäden, etwa wenn ein Kratzer über eine Delle läuft. Auch neue Fahrzeugdesigns machen die Sache nicht leichter, zum Beispiel gebogene Karosserieteile, Mattlackierungen oder integrierte Sensorflächen. Für jede neue Variante müssen Regeln manuell angepasst werden.
Industriedaten zeigen, dass die False-Reject-Rate bei bestehenden regelbasierten Systemen in solchen Szenarien auf bis zu 12 % steigen kann. Mit wachsender Fahrzeugvielfalt nimmt auch der Pflege- und Wartungsaufwand deutlich zu, weil Regeln für neue Varianten, Lackierungen oder Kamerakonfigurationen nachgezogen oder ergänzt werden müssen.
Kurz gesagt: Bei Standardfällen liefern Regelmodelle gute Ergebnisse. Wenn Licht, Oberfläche und Schadensbild wechselhaft werden, geraten sie schnell an ihre Grenzen. Genau dort wird der Vergleich mit überwachten ML-Modellen spannend.
Überwachte ML-Modelle: besser bei Bildvielfalt, aber abhängig von Trainingsdaten
Wie überwachtes Lernen Schadenarten und Schweregrade klassifiziert
Überwachte ML-Modelle – meist CNNs oder YOLOv8-basierte Detektoren – lernen mit gelabelten Fahrzeugbildern: Bauteil, Schadensart und Schweregrad. Jedes Trainingsbild hat Labels zu genau diesen drei Merkmalen. So erkennt das Modell Muster in den Trainingsdaten und ordnet neue Bilder ein.
Der Punkt ist simpel: Das Modell sieht nur so gut, wie die Daten es zulassen. Vor allem bei wechselnden Bildbedingungen zeigt sich der Abstand zur regelbasierten Logik.
Die Leistung hängt direkt von der Qualität des Datensatzes ab. Auf dem VehiDE-Dataset erreicht DamageNet 85,7 % mAP und liegt damit rund 6,2 Punkte vor der Mask-R-CNN-Baseline. Fehlen genug Beispiele für Dellen, Kratzer oder Glasbruch, fällt die Erkennung bei seltenen Klassen spürbar ab.
Für ein Gutachten ist vor allem eines wichtig: Kann das Modell sicherheitsrelevante von kosmetischen Schäden sauber trennen? Genau das wirkt sich auf Haftungsfragen und Reparaturempfehlungen aus, während KI die Schadenbewertung revolutioniert und objektive Kalkulationen ermöglicht.
Warum ML komplexe Prüfbilder besser verarbeitet als regelbasierte Systeme
ML-Modelle kommen mit uneinheitlichen Aufnahmen besser klar, weil sie aus wechselhaften Bildsituationen lernen – zum Beispiel aus Kundenfotos, Außenaufnahmen oder Bildern bei schlechtem Licht. Das macht in der Praxis einen großen Unterschied. Ein Foto aus der Werkstatt ist selten perfekt, und ein Handybild vom Parkplatz schon gar nicht.
Ein auf dem CarDD-Dataset trainiertes Modell zeigt das gut. Der Datensatz umfasst rund 4.000 Bilder und mehr als 9.000 annotierte Schadensinstanzen in sechs Kategorien. Damit kann das Modell mehrere Schadenstypen in nur einer Aufnahme erkennen.
Der Haken: ML-Modelle lassen sich schwerer erklären. Sie liefern ein Ergebnis, aber keine prüfbare Begründungskette. Grad-CAM zeigt nur, welche Bildbereiche eine Rolle gespielt haben; eine nachvollziehbare Begründung ersetzt das nicht.
Dazu kommt das Risiko von Modelldrift. Wenn neue Fahrzeuggenerationen, andere Kameratechnologien oder veränderte Aufnahmesituationen dazukommen, kann die Erkennungsleistung schleichend sinken. Deshalb braucht ML regelmäßige Audits und Retraining. Erst im direkten Vergleich wird sichtbar, wann es Regelmodelle bei Datenbedarf, Pflegeaufwand, Erklärbarkeit und Trefferquote tatsächlich schlägt.
Direkter Vergleich: Welches Modell erkennt Schäden besser – und wann?
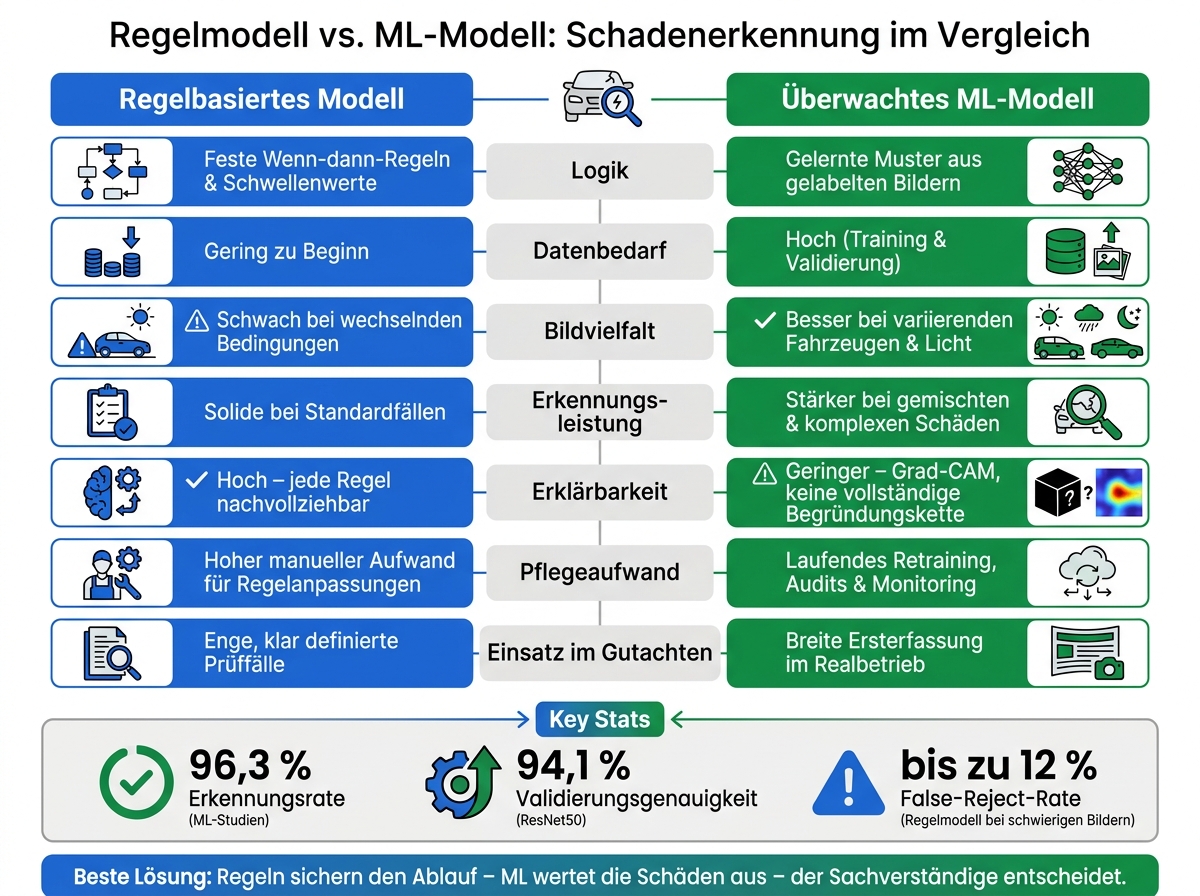
Regelmodell vs. ML-Modell: Schadenerkennung im Vergleich
Datenbedarf, Pflegeaufwand und Bildvielfalt
Nach Datenbasis und Pflegeaufwand zählt im Alltag vor allem eins: Wie gut kommt ein Modell mit wechselnden Bildern und gemischten Schäden klar?
Regelbasierte Modelle starten mit wenig Daten. Das ist erst mal angenehm. Der Haken: Sobald neue Fahrzeuge, andere Kameras oder veränderte Lichtverhältnisse ins Spiel kommen, müssen die Regeln von Hand angepasst werden.
Überwachte ML-Modelle brauchen dagegen viele gelabelte Bilder. Das kostet Zeit und Arbeit. Dafür kommen sie mit unterschiedlichen Fahrzeugen, Blickwinkeln und Bildsituationen meist besser zurecht.
Schadenarten, Erklärbarkeit und Erkennungsleistung in der Praxis
Bei stabilen Aufnahmebedingungen und einfachen, gut sichtbaren Schäden liefern regelbasierte Systeme ordentliche Ergebnisse. Wenn die Bilder immer ähnlich aussehen, spielen feste Regeln ihre Stärke aus.
Sobald die Bedingungen schwanken, liegt ML meist vorn. Das gilt vor allem bei wechselndem Licht, anderen Perspektiven oder dann, wenn mehrere Schäden gleichzeitig auftreten. ResNet50 erreicht in Studien zur Fahrzeugschadenerkennung eine Validierungsgenauigkeit von 94,1 % und übertrifft damit den manuellen Inspektionsbenchmark. Bei kombinierten Schäden, Teilüberdeckungen und unklaren Perspektiven wird dieser Vorsprung noch deutlicher.
Der größte Schwachpunkt von ML ist die geringere Nachvollziehbarkeit. Regelbasierte Systeme zeigen für jede Entscheidung klar, welche Regel gegriffen hat. Genau das ist im deutschen Gutachtenprozess wichtig, wenn Ergebnisse dokumentiert oder geprüft werden.
ML-Modelle liefern zwar ein Resultat, aber nicht immer eine lückenlose Begründung dafür. Das macht sie für Gutachten nicht untauglich. Es heißt nur: Ohne saubere Validierung und menschliche Prüfung geht es nicht.
Vergleichstabelle: Schadenerkennung im Gutachten
Der direkte Vergleich zeigt die Unterschiede auf einen Blick:
| Kriterium | Regelbasiertes Modell | Überwachtes ML-Modell |
|---|---|---|
| Logik | Feste Wenn-dann-Regeln und Schwellenwerte | Gelernte Muster aus gelabelten Bildern |
| Datenbedarf | Gering zu Beginn | Hoch, besonders für Training und Validierung |
| Umgang mit Bildvielfalt | Schwach bei stark wechselnden Bedingungen | Besser bei variierenden Fahrzeugen, Lichtverhältnissen und Winkeln |
| Leistung nach Bildkomplexität | Solide bei Standardfällen | Stärker bei gemischten und komplexen Schäden |
| Erklärbarkeit | Hoch | Geringer |
| Pflegeaufwand | Hoher manueller Aufwand für Regelanpassungen | Laufendes Retraining und Monitoring |
| Einsatz im Gutachtenprozess | Enge, klar definierte Prüffälle | Breite Ersterfassung im Realbetrieb |
Einsatz im deutschen Gutachtenprozess und Fazit
Wie die Modellwahl den digitalen Gutachtenprozess beeinflusst
Im Gutachten fällt der Unterschied vor allem im Ablauf auf. In deutschen Kfz-Gutachten folgt die Bilddokumentation meist einem festen Schema: Übersichtsfotos von allen Fahrzeugseiten, Nahaufnahmen der Schadstellen und Bilder von Fahrgestellnummer sowie Kilometerstand.
Gerade im stationären Prozess zeigen regelbasierte Systeme, was sie gut können. Sie prüfen, ob alle Pflichtbilder vorhanden sind, und melden fehlende Ansichten. Zeitstempel und Plausibilitätsprüfungen sorgen dafür, dass die Dokumentation formal sauber bleibt.
Die eigentliche Schadenanalyse übernimmt danach das ML-Modell. Es wertet die Bilder aus, lokalisiert Schäden und ordnet sie Bauteilen wie Stoßfänger, Kotflügel oder Tür zu. Je uneinheitlicher die Fotos sind, desto stärker spielt ML seine Vorteile aus. Anders gesagt: Sobald Bilder nicht mehr wie aus dem Lehrbuch aussehen, wird es für starre Regeln oft eng.
Trotz der Automatisierung bleibt die menschliche Prüfung Pflicht. Bei Grenzfällen wie einem wirtschaftlichen Totalschaden, dem Verdacht auf Vorschäden oder seltenen Fahrzeugen kann kein Modell die fachliche Verantwortung tragen. Genau an diesem Punkt zeigt sich, welcher Ansatz besser passt. Bei solchen Fällen bleibt der Sachverständige die letzte Instanz. Das gilt vor allem für gerichtsfeste und faire Gutachten.
CUBEE Sachverständigen AG setzt auf beide Wege: Standardisierte Container-Standorte schaffen kontrollierte Bedingungen für Regelmodelle. Mobile Begutachtungen bringen dagegen die Bildvielfalt mit, bei der ML stärker ist.
Fazit: Das richtige Modell hängt vom Prüfszenario ab
Regelbasierte Modelle sind vor allem dort stark, wo Bedingungen stabil sind und Anforderungen klar feststehen, zum Beispiel bei Flottenchecks oder stationären Prüfplätzen. Supervised-ML-Modelle liefern bessere Ergebnisse, wenn die Bildvielfalt groß ist und Schäden komplexer werden. Am stärksten ist die Kombination: Regeln sichern den Ablauf, ML wertet die Bilder aus, und der Sachverständige verantwortet das Ergebnis.
FAQs
Wann reicht ein Regelmodell aus?
Ein regelbasiertes Modell reicht aus, wenn Aufgaben standardisiert ablaufen und sich klare Kriterien samt festen Schwellenwerten definieren lassen.
Besonders gut passt es zur Plausibilitätsprüfung bereits erfasster Daten, zur Kontrolle von Kostenvorgaben und zur automatisierten Erstellung von Berichtstexten auf Basis fester Parameter. Vereinfacht gesagt: Das System nimmt geprüfte Eingaben und überführt sie in vordefinierte Strukturen.
Der Punkt dabei ist wichtig: Es zieht keine eigenständigen fachlichen Schlussfolgerungen. Es arbeitet nach festen Regeln – nicht nach Deutung oder Einordnung.
Wie viele Bilddaten braucht ein ML-Modell?
Das hängt stark von der Aufgabe ab. Für eine einfache Schadensklassifikation braucht ein Machine-Learning-Modell meist 500 bis 1.500 Bilder pro Klasse. Geht es um mehr als nur „Was ist das?“ - etwa um die Beurteilung des Schweregrads oder um Segmentierung - steigt der Bedarf an hochwertigen, fachlich annotierten Daten spürbar.
Kleinere oder stark spezialisierte Anwendungen kommen zum Teil schon mit weniger als 2.000 Bildern aus. Wenn aber hohe Präzision gefragt ist, brauchen leistungsfähige Deep-Learning-Systeme oft sehr große Datensammlungen. Am Ende zählen vor allem Bildqualität und Vielfalt der Daten.
Warum ist ein hybrider Ansatz oft sinnvoll?
Ein hybrider Ansatz ergibt Sinn, weil er die Stärken von KI mit menschlichem Fachwissen verbindet. KI erkennt sichtbare Schäden schnell und gleichbleibend, kommt bei komplexen, verdeckten oder strukturellen Schäden aber an ihre Grenzen.
Regelbasierte Plausibilitätsprüfungen und menschliche Endkontrollen sorgen für mehr Transparenz und Rechtssicherheit. So lassen sich Routinefälle effizient automatisieren, während Fachleute schwierige Fälle mit solidem Urteil bewerten.
Verwandte Blogbeiträge
- Top 3 Technologien hinter Predictive Analytics in KFZ-Plattformen
- Wie Deep Learning Modelle Schäden am Fahrzeug erkennen
- Wie Deep Learning Fahrzeugschäden erkennt
- CDA-Net und andere KI-Modelle für Schadensanalysen